Un e-commerce con miles de productos para la casa nos pidió personalizar sus recomendaciones con IA. Querían que alguien encontrara lo que buscaba sin tener que revisar medio catálogo.
La primera idea parecía razonable. Alguien abría una ficha, le pasábamos el contexto a un LLM y nos devolvía una selección de productos. Cada visita, una nueva respuesta.
Cuando empezamos a bajarlo a producto, apareció una pregunta que cambió el enfoque: qué iba a decidir el LLM que nuestros datos no supieran ya. Antes de elegir cómo implementarlo, teníamos que entender qué necesitaba alguien que estaba comprando.
La misma cafetera, dos decisiones
Alguien podía estar mirando cafeteras para comparar modelos. Otro ya había elegido una y buscaba un filtro compatible. En los dos casos había una cafetera en pantalla, pero la recomendación tenía que resolver algo distinto.
Separamos esas situaciones. En la ficha mostramos alternativas; en el carrito, complementos. Si alguien acababa de elegir una cafetera, llenar el carrito de otras cafeteras tenía poco sentido.
Después miramos qué datos ya teníamos. Si había elegido un rango de precio, había que respetarlo. Si había agregado algo al carrito, esa señal nos decía más que una visita suelta. Y si su última compra era una aspiradora, tampoco queríamos que eso pesara más que todo lo que estaba mirando sobre café.
Había bastante que podíamos resolver con código. Arrancamos por ahí.
El orden de los productos salía de reglas que podíamos ajustar, usando los filtros y las acciones recientes.
Dejamos preparadas las relaciones entre productos y chequeamos precio y stock antes de mostrarlos. Una cafetera podía encajar perfecto en la búsqueda y quedar afuera porque estaba agotada.
Si alguien entraba por primera vez, usábamos lo que estaba mirando. Si ni siquiera teníamos eso, mostrábamos una selección general. Le pusimos «Destacados». Para decir «Elegido para vos» necesitábamos saber un poco más.
La IA encontró trabajo en otro lado
Al armar esas relaciones nos encontramos con las fichas de producto. Cada proveedor cargaba la información a su manera. Las medidas podían venir en campos separados o metidas en un párrafo. Un mismo accesorio aparecía nombrado de distintas formas.
Ahí el LLM sí tenía algo útil para hacer. Definimos qué datos necesitábamos por familia de productos y lo usamos para extraer atributos de las descripciones y los documentos del proveedor.
Guardábamos de dónde había salido cada dato y validábamos antes de usarlo. El equipo comercial revisaba las compatibilidades. Si la ficha no decía cuánto ruido hacía una cafetera, dejábamos ese campo vacío. Necesitábamos un catálogo con el que pudiéramos trabajar y saber qué datos nos faltaban.
Hacíamos eso cuando entraba o cambiaba un producto. Después, los atributos quedaban guardados y servían para todas las visitas. No tenía sentido volver a leer la misma descripción cada vez que alguien abría una ficha.
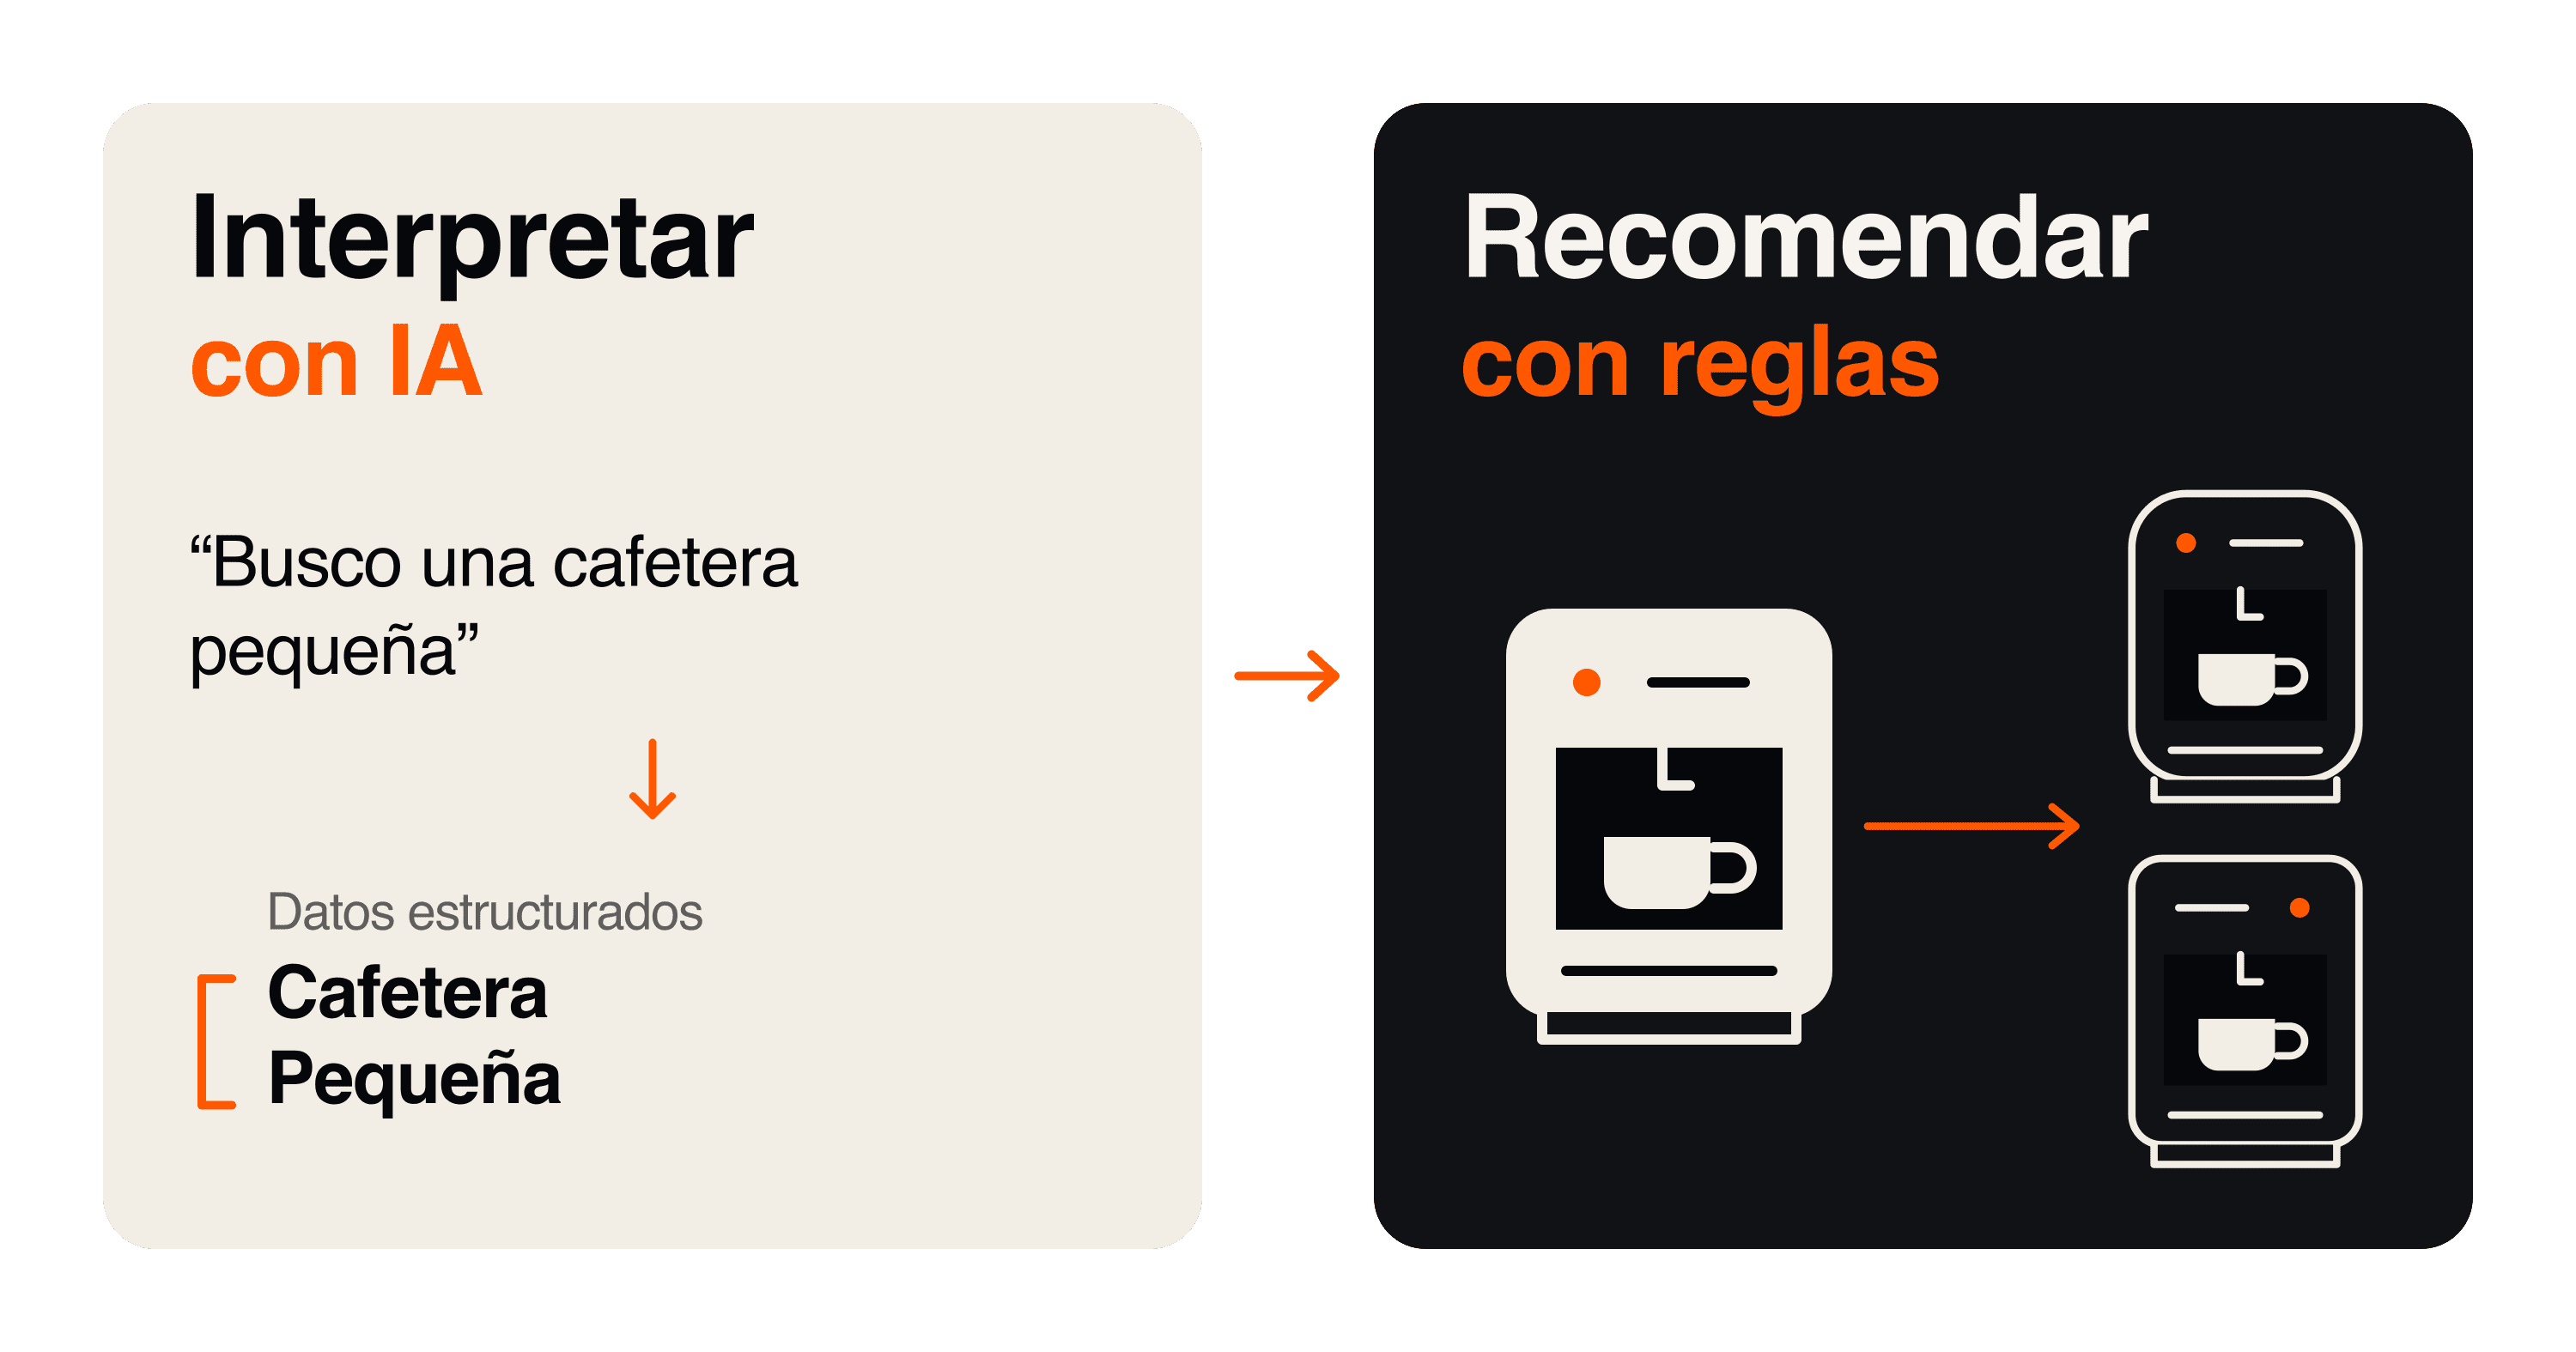
El otro lugar donde usamos el LLM fue la búsqueda. «Busco una cafetera pequeña para una oficina» no venía armado como una lista de filtros. El modelo nos ayudaba a llevar ese pedido a una categoría y condiciones que podíamos chequear contra el catálogo.
Si alguien pedía una cafetera silenciosa y no teníamos datos de ruido, lo indicábamos. Si «para una oficina» no nos alcanzaba para entender qué buscaba, pedíamos una aclaración. El LLM interpretaba el pedido; los productos salían del catálogo.
Ahí se nos ordenó el criterio: IA para entender lo que venía abierto o desordenado. Para trabajar con datos que ya teníamos estructurados, alcanzaba con código.
Una búsqueda abierta podía necesitar una llamada al LLM. Cambiar el filtro de precio o volver a abrir una ficha, no.
Un recomendador que podíamos corregir
Terminamos con bloques de alternativas y complementos, una búsqueda abierta y una herramienta interna para revisar atributos y relaciones. Y esto era importante: si una recomendación estaba mal, el equipo tenía que poder entender por qué.
Si aparecía un accesorio incompatible, podían revisar la relación. Si se repetían demasiado los mismos productos, ajustaban los pesos. Guardábamos los motivos de cada recomendación. Cuando algo salía mal, sabíamos dónde mirar.
Las recomendaciones habituales ya no tenían que esperar una respuesta del LLM. Si fallaba la interpretación de una búsqueda, seguían disponibles las categorías y los filtros. El e-commerce podía seguir funcionando aunque esa parte fallara.
También cambió cómo pensábamos los costos. Pasamos de una llamada por visita a usar el LLM para preparar el catálogo y entender búsquedas. Eso sacaba al LLM del recorrido habitual de compra. Para saber cuánto ahorrábamos en total, todavía teníamos que sumar datos, infraestructura y mantenimiento.
Antes de agregar otra llamada, teníamos que poder explicar qué resolvía y por qué hacía falta un LLM ahí.
Aprendimos que no daba lo mismo dónde poner la IA. Cuanto más cerca estaba de una decisión en tiempo real, más difícil era entenderla, corregirla y mantenerla. Con los atributos guardados y las reglas a la vista, podíamos seguir el rastro de una recomendación. Si algo estaba mal, sabíamos qué cambiar.
La siguiente versión tenía que ganarse su lugar
El próximo paso era hacer un A/B test entre una selección general y el recomendador, con visitantes asignados al azar. Queríamos comparar compras además de clics y ver si ayudaba a elegir.
Si las reglas llegaban a su techo, probaríamos un modelo de ranking entrenado con datos de uso. Lo compararíamos con lo que ya teníamos, manteniendo los chequeos de catálogo y stock.
Alguien encuentra una cafetera, entiende sus alternativas y elige un accesorio compatible. Si la siguiente versión no hacía esa compra más fácil, no necesitábamos una siguiente versión.
Fuentes
- Google Developers: Recommendation systems overview. Actualizado el 25 de agosto de 2025.
- Anthropic: Building effective agents. Publicado el 19 de diciembre de 2024.