Publicado el 1 de septiembre de 2026. Actualizado el 17 de septiembre de 2026, después de que Cloudflare lanzara una opción que elimina el dilema que este artículo describía.
El 15 de septiembre de 2026 cambió lo que pasa cuando un sitio le dice que no a la AI. Cloudflare dejó de ordenar a los robots por si son AI y pasó a ordenarlos por lo que vienen a hacer, y ofrece tres formas de negarse. Dos de ellas, Block y "Block on pages with ads", ahora alcanzan también a Googlebot, a Bingbot y a Applebot, porque esos tres hacen dos trabajos a la vez. La tercera, Disallow AI Training, rechaza el entrenamiento y conserva la búsqueda. Cuál elegiste es toda la diferencia.
Esa configuración ya no es una decisión de seguridad. Qué visitantes automáticos entran define en parte si tus productos aparecen cuando alguien le pide una recomendación a un asistente. Es una pregunta de quien responde por el tráfico, y vive en el panel de infraestructura, no en el producto.
Tres trabajos, no dos clases de robot
Cloudflare publicó la clasificación el 1 de julio de 2026. En vez de preguntar si un bot es AI, pregunta a qué vino, y admite tres respuestas (las citas de Cloudflare son traducción nuestra). Search es "cualquier comportamiento que recolecta o indexa tu contenido para poder responder preguntas sobre él más adelante". Agent es la automatización que "actúa, casi siempre en tiempo real, en nombre de una persona, para resolver algo ahora": un chatbot abriendo una página en medio de una conversación, un asistente manejando un navegador. Training es "un crawler que se lleva tu contenido para entrenar o afinar un modelo".
La medición de Cloudflare ubica a los crawlers de uso mixto, los que mezclan búsqueda, agente y entrenamiento bajo un identificador único, en más del 36% de la actividad, y dice que en junio de 2026 el 52% de los pedidos de crawlers era para entrenamiento de AI, contra 22% en la primavera boreal de 2025. Cloudflare mide su propia red y vende los productos de los que habla: es quien mejor ve el problema y quien más gana si lo resolvés a su manera.
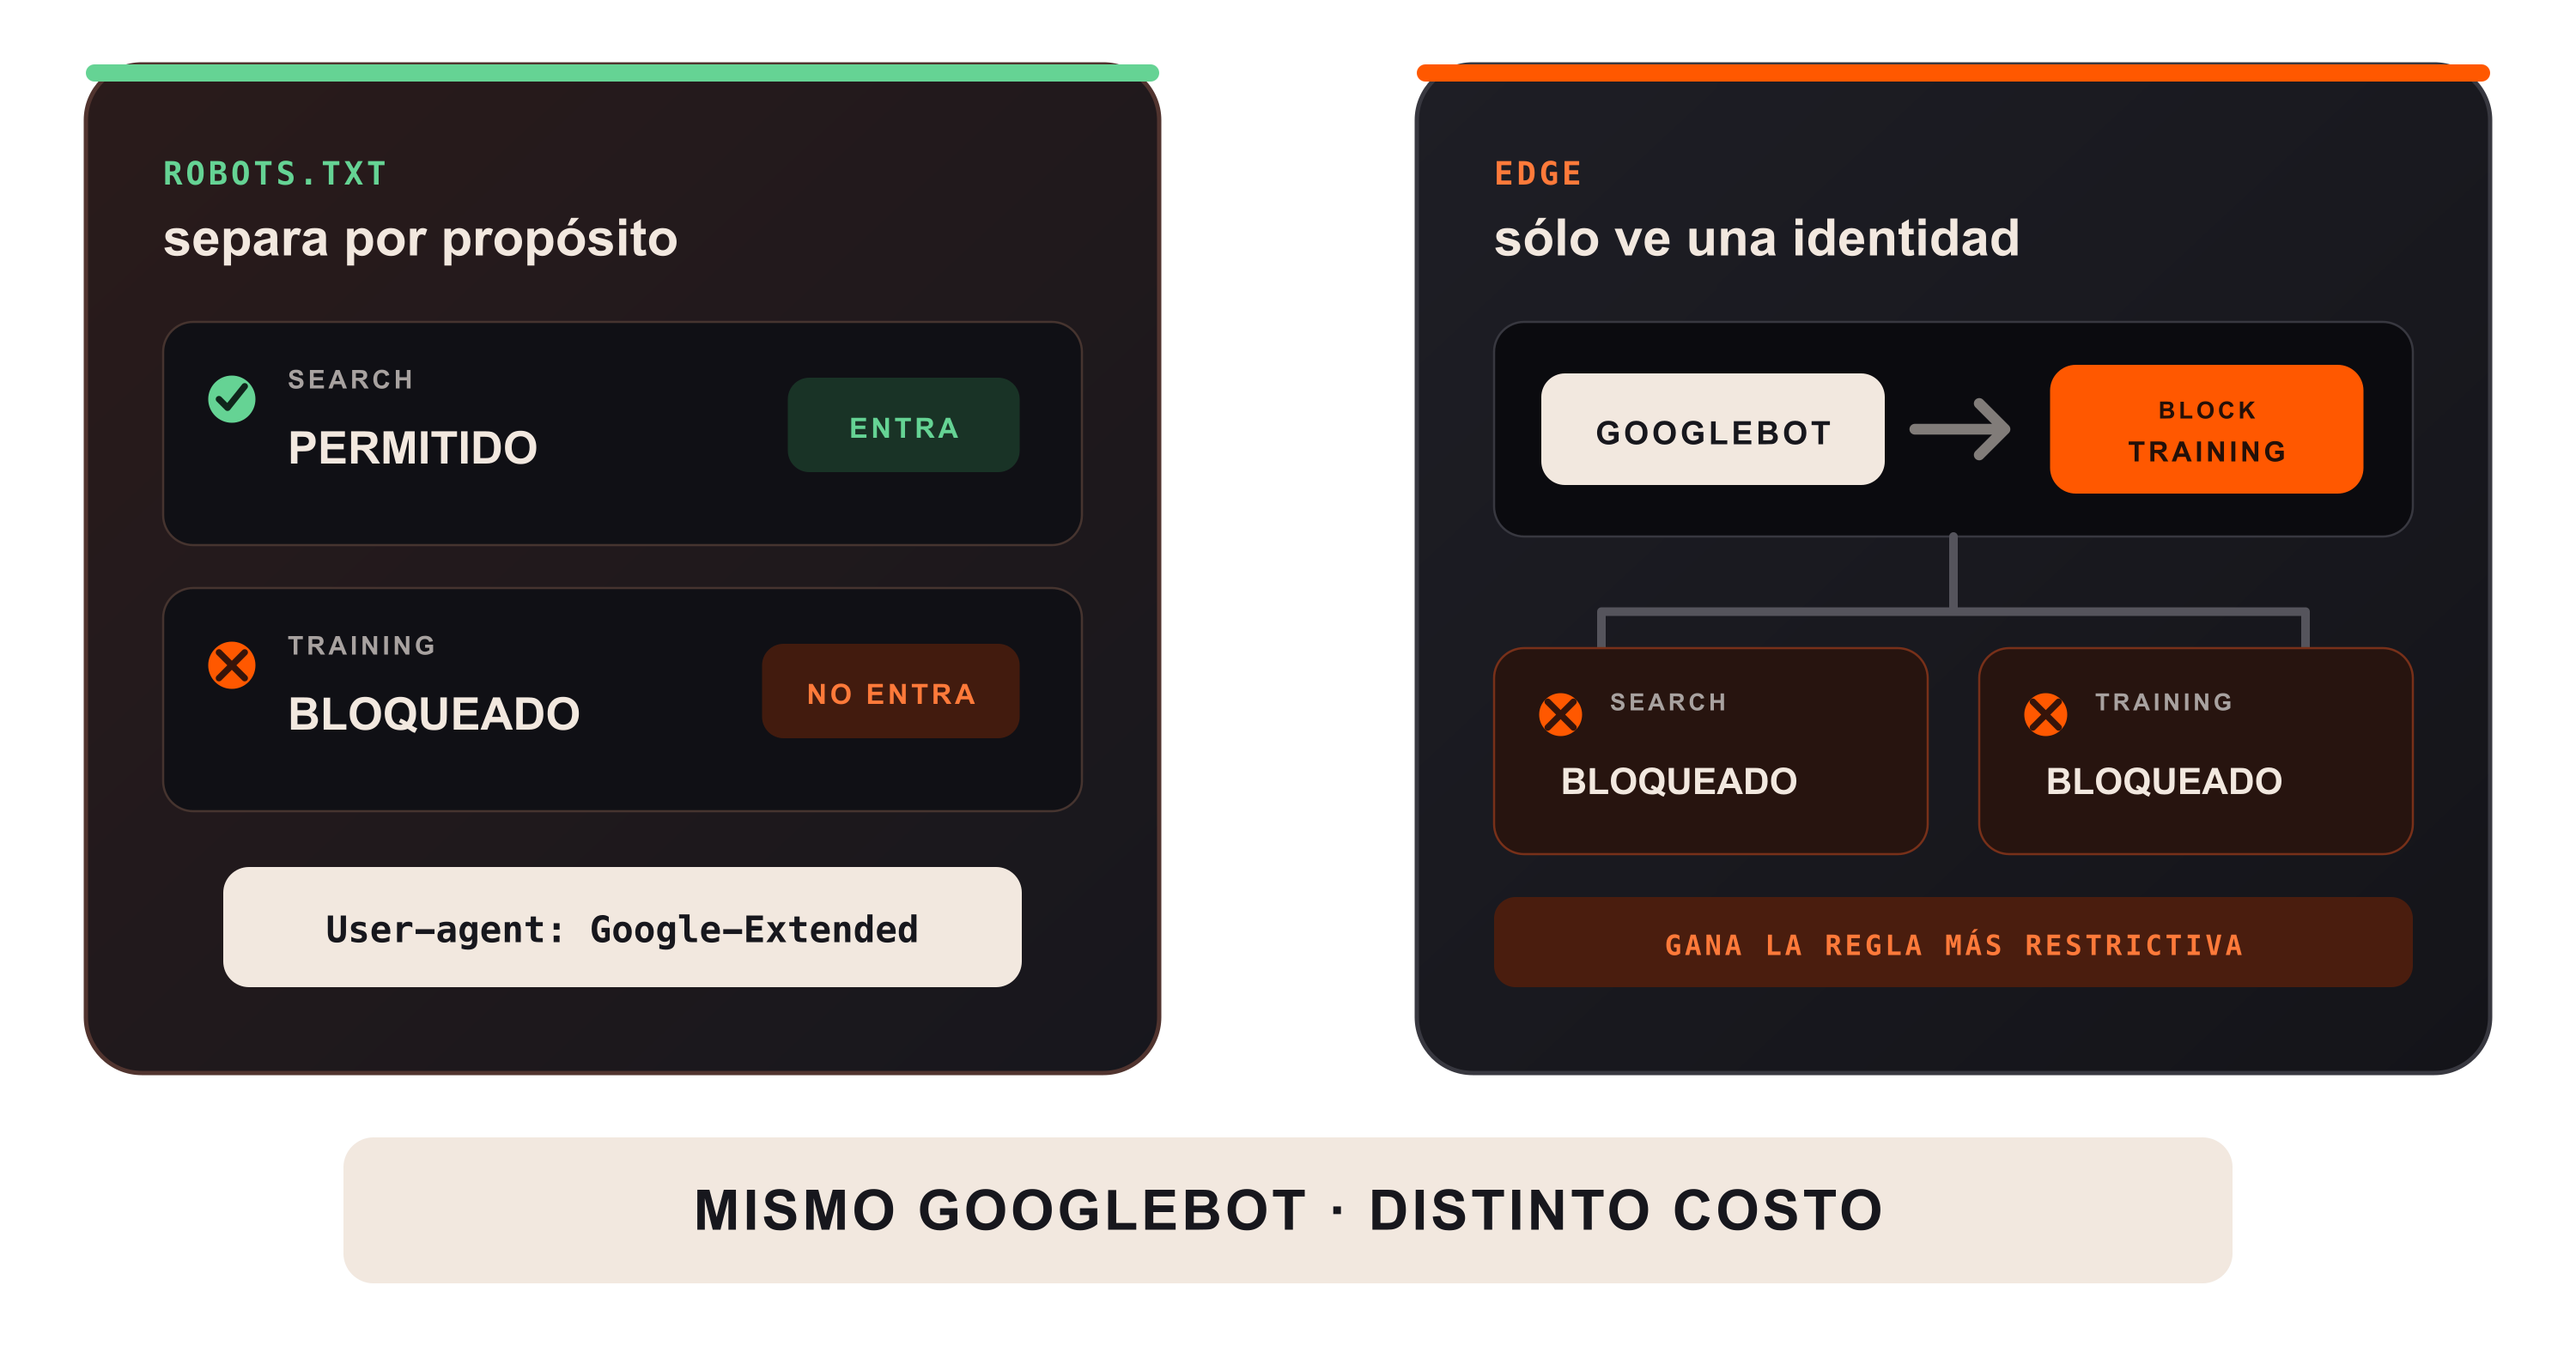
Cuando un crawler hace dos de los tres trabajos, las opciones brutas aplican "las reglas más restrictivas que correspondan". Googlebot indexa para búsqueda y recolecta para entrenamiento, así que elegir Block, o Block on pages with ads, hace que deje de entrar del todo. Cloudflare lo dice sin vueltas: seleccionar Block los frena por completo, búsqueda incluida.
Dónde escribís la negativa decide cuánto te cuesta
La misma negativa, escrita en dos lugares distintos, daba resultados opuestos. Eso es lo que cambió, y cómo cambió es lo interesante.
Google documenta un token para excluirse, Google-Extended, que controla si el contenido rastreado entrena a Gemini y fundamenta sus respuestas. La documentación oficial en castellano dice que "Google-Extended no afecta a la inclusión de los sitios en la Búsqueda de Google", y es igual de explícita sobre el mecanismo: "Google-Extended no tiene una cadena de user-agent de solicitud HTTP independiente. El rastreo se hace con las cadenas de user-agent de Google."
En robots.txt, el archivo donde un sitio declara sus preferencias y confía en que los crawlers las respeten, la negativa se dirige a un propósito. En el borde de la red sólo podía dirigirse a un pedido, y un pedido trae un user-agent, el nombre con el que un programa se presenta, no una intención. Nuestra lectura en septiembre fue que el mecanismo cortés era más preciso que el que se hace cumplir. La solución de Cloudflare es la prueba: Disallow AI Training funciona publicando una directiva Disallow en tu robots.txt, y se llama así por eso. La red no reemplazó al pedido. Aprendió a escribirlo.
No hay default correcto
El 21 de agosto de 2026 Cloudflare lanzó una función que reescribe tu robots.txt para que coincida con lo configurado en el borde, y el ejemplo que la justifica liquida la idea de una respuesta única: "un ecommerce puede querer que todo sea rastreado y entrenado, para que sus productos aparezcan cuando alguien le pregunta a un chatbot por 'el mejor sillón para un departamento chico'. Un medio que monetiza con publicidad puede querer lo contrario."
La objeción evidente es quién tiene la llave. En Tech Policy Press, en julio de 2025 y sobre la vuelta anterior, Luke Hogg y Tim Hwang calificaron de "profundamente preocupante" que una sola empresa, con "más del 82 por ciento del mercado global de software de protección contra DDoS y bots", moviera el default. Nuestra posición: tienen razón sobre la concentración y no sobre la alternativa. Robots.txt siempre fue un pedido, y un pedido que hay que hacer cumplir se cumple donde está la red. Lo que sigue es elegir, no heredar.
Qué hacer ahora
Nada urgente, y ésa es la corrección a lo que este artículo dijo primero. Cloudflare migró solo a los clientes existentes, y las selecciones previas de Block o Block on pages with ads en Training pasaron a Disallow AI Training. El trabajo es entrar a la configuración de tráfico AI en Security y confirmar que la opción dice lo que querés decir, porque las tres cuestan cosas distintas. Si tenés una tienda, la respuesta honesta puede seguir siendo que querés que te rastree todo el mundo, que coincide con qué encuentra ChatGPT cuando entra a tu sitio.
Al lado de eso va un límite, porque es la razón por la que esto no está terminado. Cloudflare dice que Disallow AI Training todavía no le transmite a Bing la preferencia de no entrenar por robots.txt: Microsoft lo está construyendo y lo apunta a principios de 2027. Apple, Google y Microsoft afirman que rechazar el entrenamiento no afecta el ranking de búsqueda, y Amazon, Anthropic, Meta y OpenAI ya corrían crawlers separados de búsqueda y de entrenamiento, así que bloquearles el entrenamiento nunca costó el índice.
Lo que dijimos que había que mirar era si Google iba a partir a Googlebot en dos. No lo hizo, y el dilema se disolvió igual: en vez de que cada operador partiera su crawler, Cloudflare armó una designación, la llamó Accountable, y puso respetar un propósito como precio de conservar el acceso a la búsqueda. Lo que vale mirar ahora es si eso se sostiene sin un estándar detrás, o si ai-prefs en la IETF convierte una designación privada en una regla pública.
Fuentes
- Cloudflare, "Have it both ways: stay discoverable in search while disallowing AI training", 15 de septiembre de 2026.
- Cloudflare, "Your site, your rules", 1/7/2026.
- Cloudflare, "Content Independence Day, one year on", 1/7/2026.
- Cloudflare, "Bot Preference Sync", 21/8/2026.
- Google Search Central, "Rastreadores de Google", consultado el 17/9/2026.
- Tech Policy Press, "Guardian to Gatekeeper", 9/7/2025.